Exercice 2 Asie – Bac NSI 2025 – Jour 1
mots clés: arbres, compression fichier texte
🔎 Voir les exercices similaires ↓
Asie – Bac NSI 2025 – Jour 1 Énoncé de l'exercice 2
Cet exercice porte sur les arbres et la compression d’un fichier texte.
Quand il s’agit de transmettre de l’information sur un canal non bruité, l’objectif prioritaire est de minimiser la taille de la représentation de l’information : c’est le problème de la compression de données. Le code de Huffman (1952) est un code de longueur variable optimal, c’est-à-dire tel que la longueur moyenne d’un texte codé est minimale. On observe ainsi des réductions de taille de l’ordre de 20 % à 90 %. Ce code est largement utilisé, souvent combiné avec d’autres méthodes de compression.
Partie A : Coder du texte
On donne, en Figure 1 ci-dessous, la table d’encodage hexadécimal des caractères ISO/CEI 8859-1, dite ASCII Latin 1.
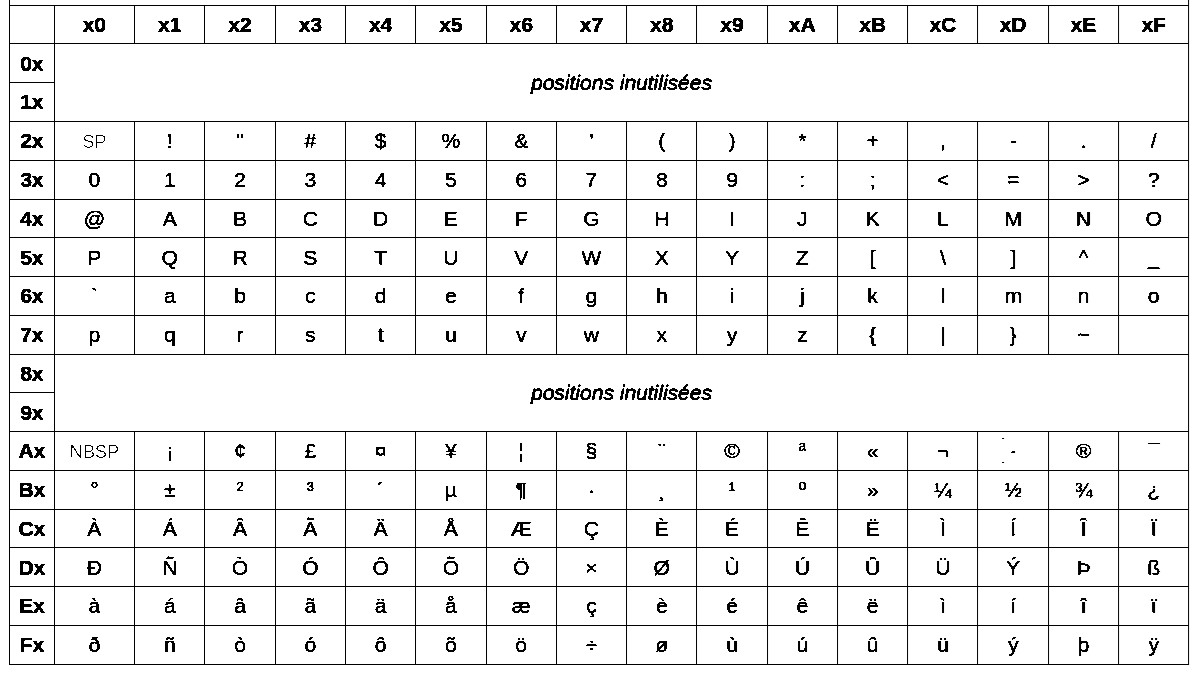
Chaque caractère est codé sur 8 bits, soit deux chiffres hexadécimaux, correspondant respectivement à la ligne et à la colonne à l’intersection desquelles il figure.
Par exemple, pour la lettre ‘H’ figurant à l’intersection de la ligne ‘4x’ et de la colonne ‘x8’, le code hexadécimal est ‘48’.
La chaîne de caractère ‘Hello_World_!’ est codé par :
‘48 65 6C 6C 6F 5F 57 6F 72 6C 64 5F 21’
Dans cette table, le caractère ESPACE est symbolisé par SP.
Soit la chaîne de caractères txt = "SIX ANANAS".
Calculer la taille en octets du texte contenu dans la variable txt. En déduire la taille en bits nécessaire pour le stocker.
Donner le codage de la chaîne de caractères txt.
Partie B : Compression de Huffman
Nombre d’occurrences
On appelle nombre d’occurrences d’un symbole le nombre de répétitions de ce symbole dans le texte étudié. Ainsi, dans la phrase “DEECDDEBFACCECCEDBAEE” on peut associer le tableau d’occurrences ci-dessous :
| Symbole | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| Nombre d’occurrences | 2 | 2 | 5 | 4 | 7 | 1 |
Écrire le tableau d’occurrences associé à la chaîne de caractères txt.
Préciser à quoi correspond la somme des nombres d’occurrences.
Ce tableau d’occurrences peut être stocké dans un dictionnaire Python où les clés sont les symboles rencontrés dans le texte et les valeurs les nombres d’occurrences de chaque symbole. Ainsi, pour l’exemple ci-dessus, le dictionnaire serait {'D' : 4, 'E' : 7, 'C' : 5, 'B' : 2, 'F' : 1, 'A' : 2}.
Recopier et compléter le code de la fonction occurrence ci-dessous qui, pour un texte passé en paramètre, renvoie le dictionnaire d’occurrences associé.
def occurrence(texte):
    dico = {}
    for lettre in ... :
        if lettre in ... :
            dico[lettre] = dico[lettre]+1
        else:
            ...
    return ...
Arbre de Huffman
L’algorithme de Huffman met en œuvre plusieurs structures de données. Il opère sur un ensemble dynamique d’arbres binaires pondérés (une forêt), structuré en file à priorité.
Initialement, la forêt est constituée d’arbres binaires,
tous restreints à leur seule racine, dont l’étiquette est un symbole du texte ;
et respectivement dotés d’un poids correspondant à l’effectif de ce symbole.
Une opération de greffe de deux arbres pondérés est possible : l’arbre résultant est un arbre binaire dont :
la racine est un nœud sans étiquette ;
les sous-arbres gauches et droits sont les deux arbres greffés ;
le poids est la somme des poids de ces deux sous-arbres.
La file à priorité, qui contient tous les arbres considérés, est une structure permettant
l’extraction : le premier arbre disponible est un arbre de priorité maximale parmi tous les arbres ;
l’insertion : tout nouvel arbre pondéré est inséré
après tous ceux qui ont une priorité strictement plus grande que la sienne ;
avant tous ceux qui ont une priorité inférieure ou égale à la sienne.
Pour construire l’arbre de Huffman, tant que la forêt compte au moins deux arbres,
les deux arbres prioritaires sont extraits de la file ;
ils sont greffés en un nouvel arbre pondéré ;
et celui-ci est inséré dans la file à priorité.
Une fois l’arbre construit, on pondère les arêtes en partant de la racine : 0 pour les arêtes menant aux enfants gauches, 1 pour les arêtes menant aux enfants droits.
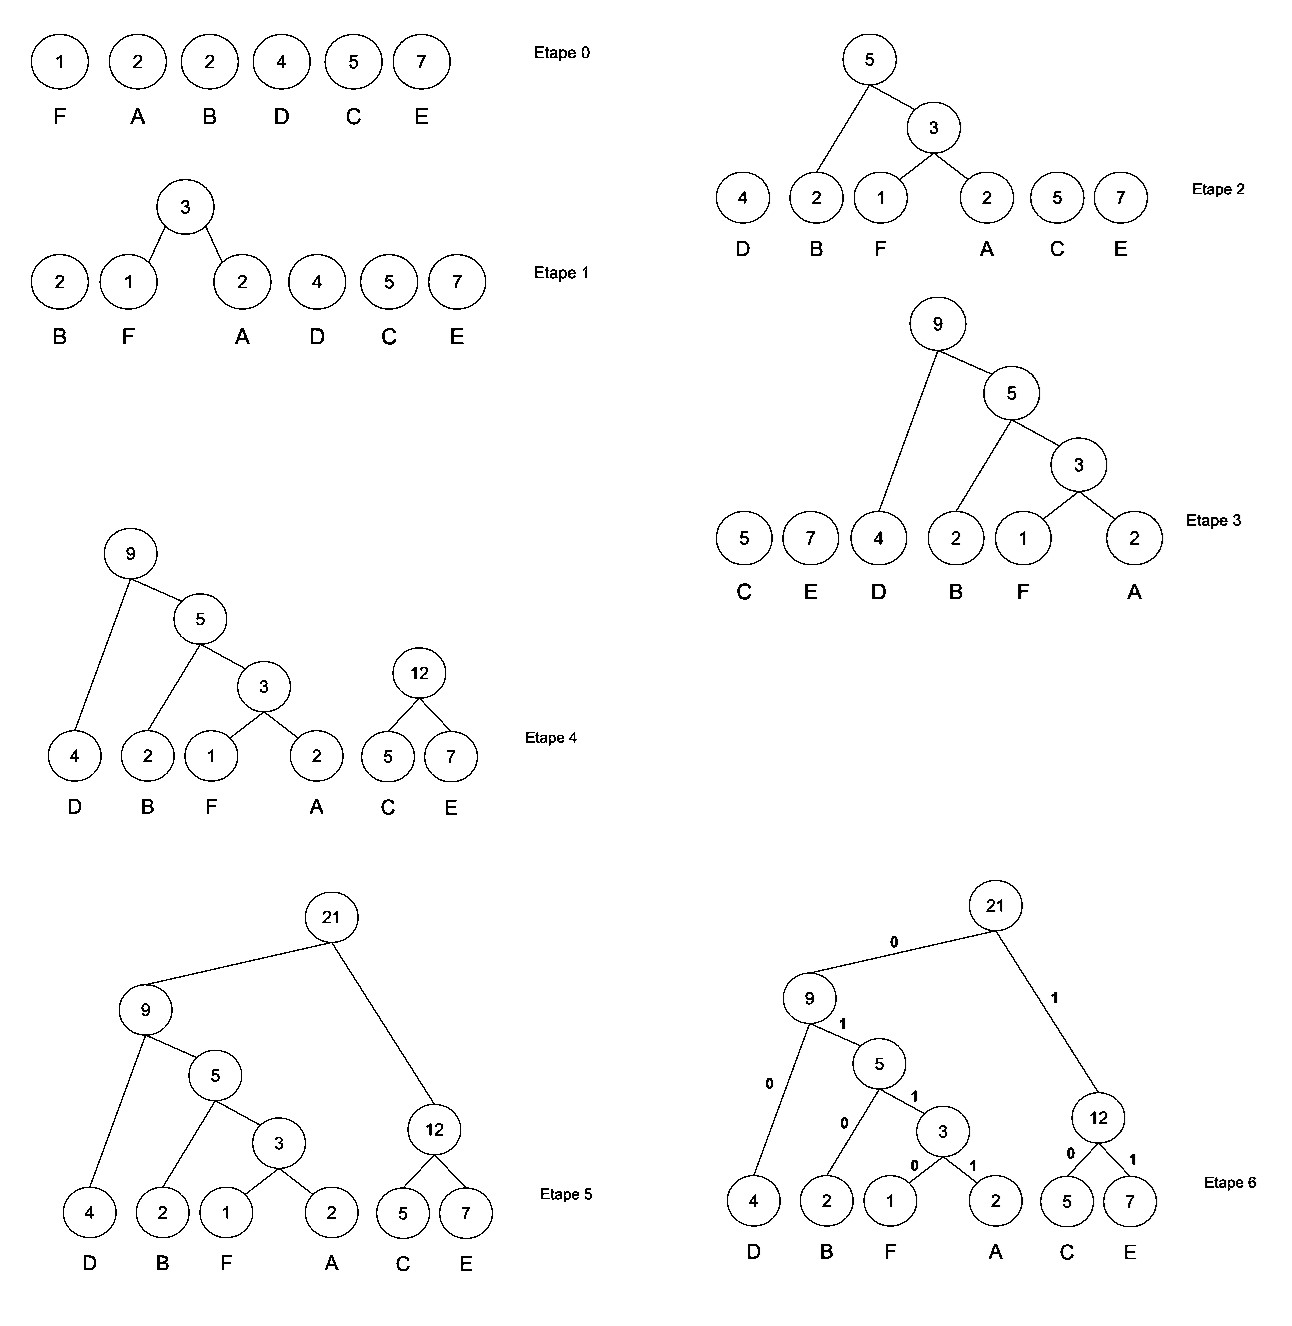
Le schéma de la figure ci-dessous indique comment on construit un arbre de Huffman en fonction du tableau d’occurrences.
Pour plus de clarté, les étiquettes de tous les nœuds ont été remplacées par le poids de l’arbre dont ils sont la racine.
Construire l’arbre de Huffman associé à la chaîne de caractères txt.
Préciser à quoi correspond le poids de la racine de cet arbre.
Codage et compression à l’aide de l’arbre de Huffman
À l’aide de l’arbre de Huffman, on peut créer une table de codage où chaque symbole est codé par les bits lus sur le chemin entre la racine de l’arbre et la feuille correspondant au symbole. Dans l’exemple ci-dessus, la lettre ‘F’ serait codée par 0110 et la lettre ‘E’ par 11.
Indiquer le type de parcours à utiliser sur l’arbre de Huffman pour réaliser cette table de codage.
Donner la table de codage pour la chaîne de caractères txt.
Justifier le fait que le code de Huffman est un code de longueur variable.
Le codage du texte se fait ensuite caractère par caractère en utilisant la table de codage.
Coder la chaîne de caractères txt à l’aide du code de Huffman et de l’arbre construit à la question 6.
En reprenant le résultat déterminé dans la partie A, en déduire le taux de compression en % pour la variable txt et vérifier l’assertion du texte d’introduction : “On observe ainsi des réductions de taille de l’ordre de 20 % à 90 %.”
Le taux de compression est le ratio
Asie – Bac NSI 2025 – Jour 1 Correction de l'exercice 2
Partie A – Coder du texte
1. Taille du texte txt = "SIX ANANAS"
La chaîne "SIX ANANAS" contient :
S I X → 3 caractères
ESPACE → 1 caractère
A N A N A S → 6 caractères
Total : 10 caractères
Réponse :
Taille en octets : 10 octets
Taille en bits : 10 × 8 = 80 bits
2. Codage hexadécimal de la chaîne txt
On utilise la table ISO/CEI 8859-1.
| Caractère | S | I | X | SP (espace) | A | N |
|---|---|---|---|---|---|---|
| Code hexadécimal | 53 | 49 | 58 | 20 | 41 | 4E |
Réponse :
53 49 58 20 41 4E 41 4E 41 53Partie B – Compression de Huffman
3. Tableau d’occurrences de txt
Texte :
S I X A N A N A S| Symbole | S | I | X | SP | A | N |
|---|---|---|---|---|---|---|
| Nombre d’occurrences | 2 | 1 | 1 | 1 | 3 | 2 |
4. Signification de la somme des occurrences
Somme :
2 + 1 + 1 + 1 + 3 + 2 = 10La somme des occurrences correspond au nombre total de caractères du texte.
5. Fonction Python occurrence
def occurrence(texte):
    dico = {}
    for lettre in texte:
        if lettre in dico:
            dico[lettre] = dico[lettre] + 1
        else:
            dico[lettre] = 1
return dico6. Construction de l’arbre de Huffman
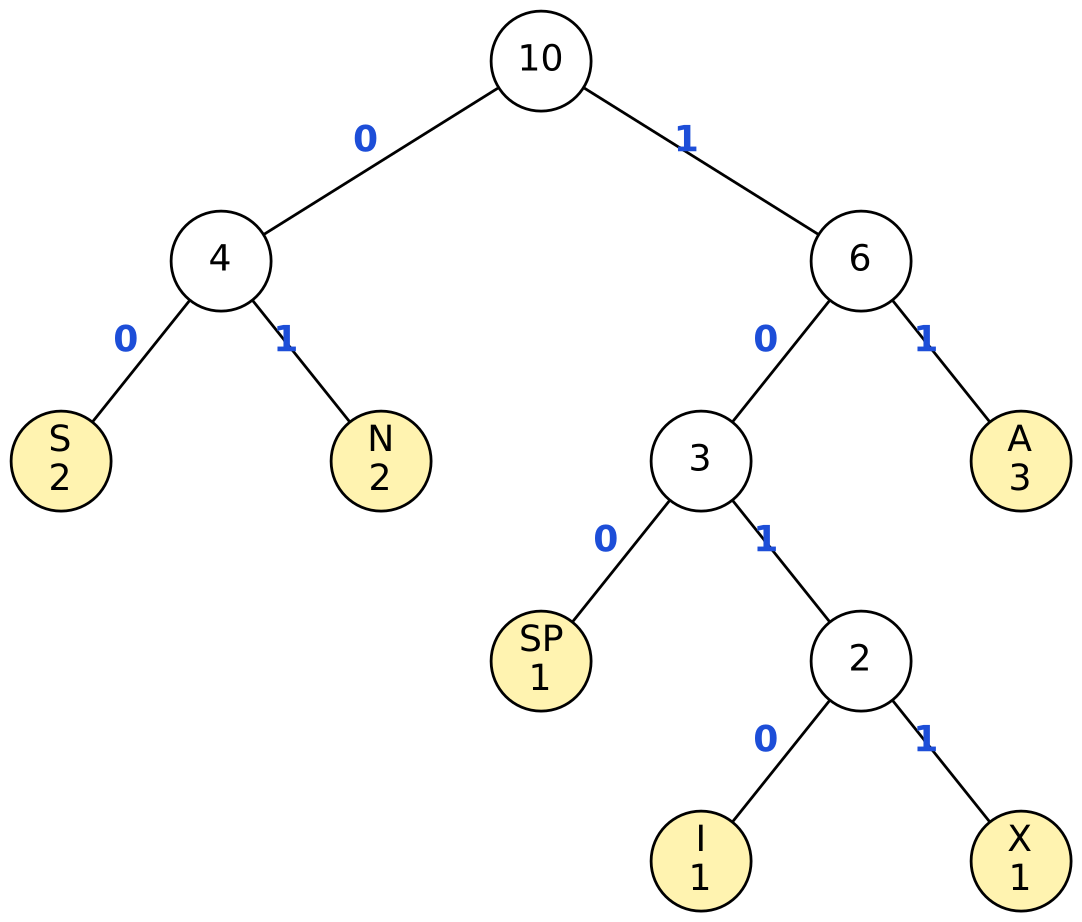
On range les arbres par poids croissant (à poids égal, dans l’ordre d’apparition dans le texte) : I(1), X(1), SP(1), S(2), N(2), A(3). À chaque étape, on extrait les deux premiers arbres (le premier extrait à gauche), on les greffe, et le nouvel arbre est inséré avant les arbres de poids supérieur ou égal :
I(1) + X(1) → 2 ; file : SP(1), 2, S(2), N(2), A(3)
SP(1) + 2 → 3 ; file : S(2), N(2), 3, A(3)
S(2) + N(2) → 4 ; file : 3, A(3), 4
3 + A(3) → 6 ; file : 4, 6
4 + 6 → 10 : il ne reste qu’un arbre, c’est l’arbre de Huffman.
7. Poids de la racine
Poids de la racine : 10. C’est la somme des nombres d’occurrences, c’est-à-dire le nombre total de caractères du texte txt.
8. Type de parcours pour créer la table de codage
Un parcours en profondeur (par exemple préfixe) : on descend de la racine vers chaque feuille en ajoutant 0 à chaque passage à gauche et 1 à chaque passage à droite.
9. Table de codage de Huffman
On lit les bits sur le chemin de la racine à chaque feuille de l’arbre de la question 6 :
| Symbole | S | N | SP | I | X | A |
|---|---|---|---|---|---|---|
| Code | 00 | 01 | 100 | 1010 | 1011 | 11 |
⚠️ Remarque : selon l’ordre choisi à poids égal, d’autres tables sont possibles, toutes valables tant que :
aucun code n’est le début d’un autre (code préfixe), ce qui permet de décoder sans séparateur ;
les symboles fréquents ont des codes plus courts (ou égaux).
10. Pourquoi le code de Huffman est un code de longueur variable
Les codes n’ont pas tous la même longueur : ici de 2 bits (S, N, A) à 4 bits (I, X). Les symboles fréquents sont codés avec peu de bits, les symboles rares avec davantage de bits.
Cela permet de réduire la longueur moyenne du message codé.
11. Codage de txt avec Huffman
Texte :
S I X ESPACE A N A N A SCodage : 00 1010 1011 100 11 01 11 01 11 00
Message binaire : 0010101011100110111011100
Longueur : 25 bits (3 × 2 bits pour A, 2 × 2 pour S, 2 × 2 pour N, 3 bits pour SP, 4 bits pour I et pour X).
12. Taux de compression
Taille initiale (Partie A)
80 bits
Taille compressée
25 bits
Calcul du taux de compression
Taux = (80 − 25) / 80 = 55 / 80 = 0,6875
Taux de compression : 68,75 % (environ 69 %)
Une erreur, un oubli ? Écrivez-moi : frederic.peuriere@lfcl.pt
🔎 Exercices sur des thèmes similaires
-
Métropole 2025 – jour 1 – exercice 3
réseau, routage, arbres binaires de recherche, programmation — Difficulté : 🔥🔥🔥🔥🔥 -
Asie 2025 – jour 2 – exercice 3
POO, BDD, SQL, arbres binaires — Difficulté : 🔥🔥🔥🔥🔥 -
Centres étrangers 2024 – jour 2 – exercice 2
POO, récursivité, arbres binaires, systèmes d'exploitation — Difficulté : 🔥🔥🔥🔥🔥 -
Polynésie 2023 – jour 2 – exercice 1
arbres binaires de recherche, POO, récursivité — Difficulté : 🔥🔥🔥🔥🔥 -
Sujet Zéro 2023 – jour 1 – exercice 3
arbres binaires de recherche , POO — Difficulté : 🔥🔥🔥🔥🔥 -
Sujet Zéro 2023 – jour 2 – exercice 3
arbres binaires de recherche, POO — Difficulté : 🔥🔥🔥🔥🔥